
第 10 章 数据驱动设计与实验
"数据驱动"是这些年设计圈最时髦的词之一。但在 ToB 语境里,它既被高估,又被低估:高估的是那种照搬 ToC 的 A/B 测试迷信,低估的是数据本可以为 ToB 设计带来的扎实判断。这一章,想把这件事说清楚,尤其是 ToB 用数据时那些和 ToC 截然不同的现实。
先亮出这一章的核心立场:数据是用来"指导判断"的,不是用来"替代判断"的。一个把数据奉为圣旨、放弃自己判断的设计师,和一个完全凭直觉、拒绝看数据的设计师,是同样不成熟的。成熟的姿势,是让数据和判断互相校准、彼此增强。这正是序章"理性之美"在这一章的体现:理性不是用数字取消人的判断,而是用数字让判断更可靠。
一、为什么 ToB 不能照搬 ToC 的数据玩法
要理解 ToB 数据驱动的特殊性,先得看清它和 ToC 的几个根本不同。这几个不同,会让很多照搬 ToC 的做法在 ToB 失灵。
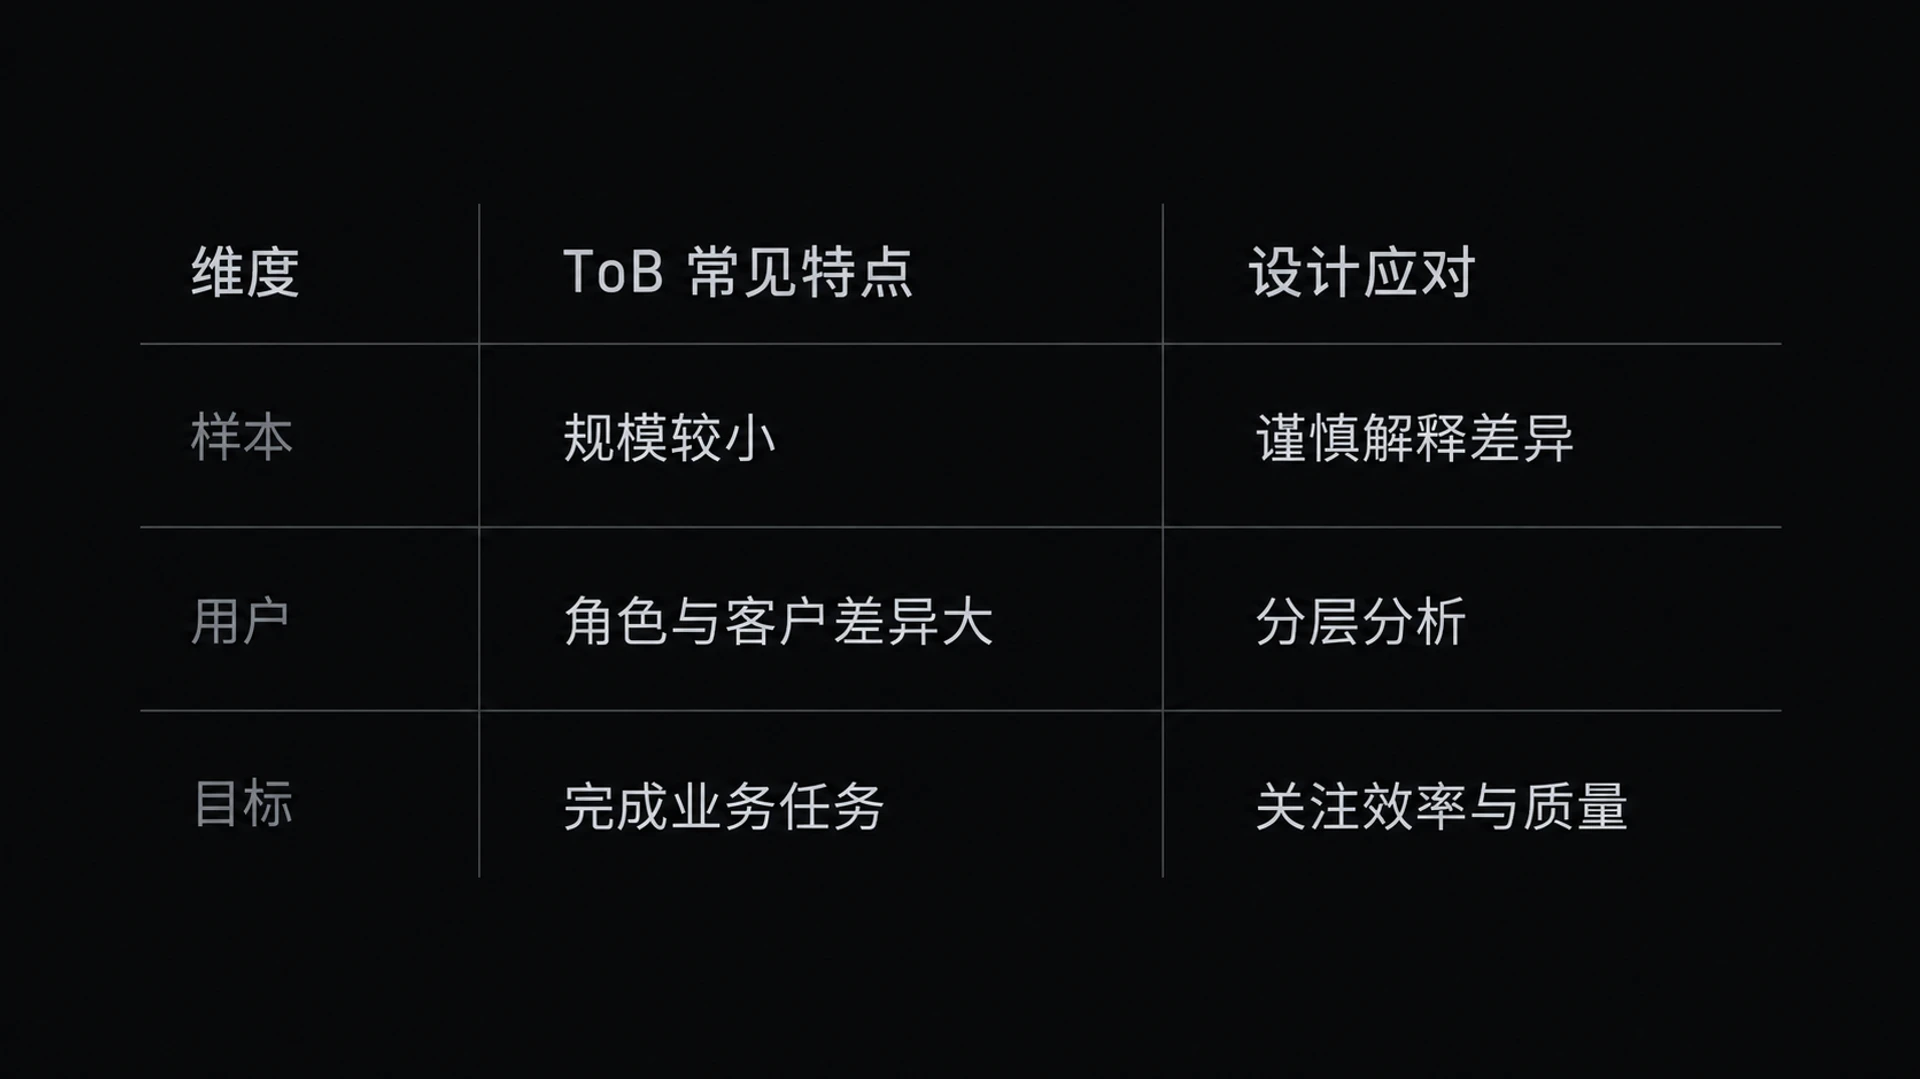
第一,样本量小。这是最致命的差异。ToC 产品动辄百万、千万日活,数据海量,任何细微的差异都能跑出统计意义。ToB 呢?一个企业级产品,日活可能只有几千、几百,某些专业角色(比如"风控审核员"这个角色)甚至只有几十个用户。在这么小的样本上,经典的统计方法常常失灵,你看到的"差异",很可能只是噪声(随机波动),而不是真实的效果。这一条,直接动摇了很多照搬自 ToC 的数据方法的根基,尤其是 A/B 测试。
第二,用户异质性高。ToC 的用户在统计上可以被当成相对同质的群体。ToB 的用户高度异质:不同角色、不同行业、不同规模的客户,行为模式天差地别。一个大型制造业客户和一个小型贸易公司,用同一个系统的方式可能完全不同。把这些异质的用户混在一起算平均,得到的数字往往毫无意义,甚至误导。
第三,目标不同,指标也不同。ToC 关心的是点击率、停留时长、留存、转化,很多是"吸引和留住"导向的。ToB 关心的根本不是这些。第一章讲过,ToB 追求的是效率、确定性、可靠性。
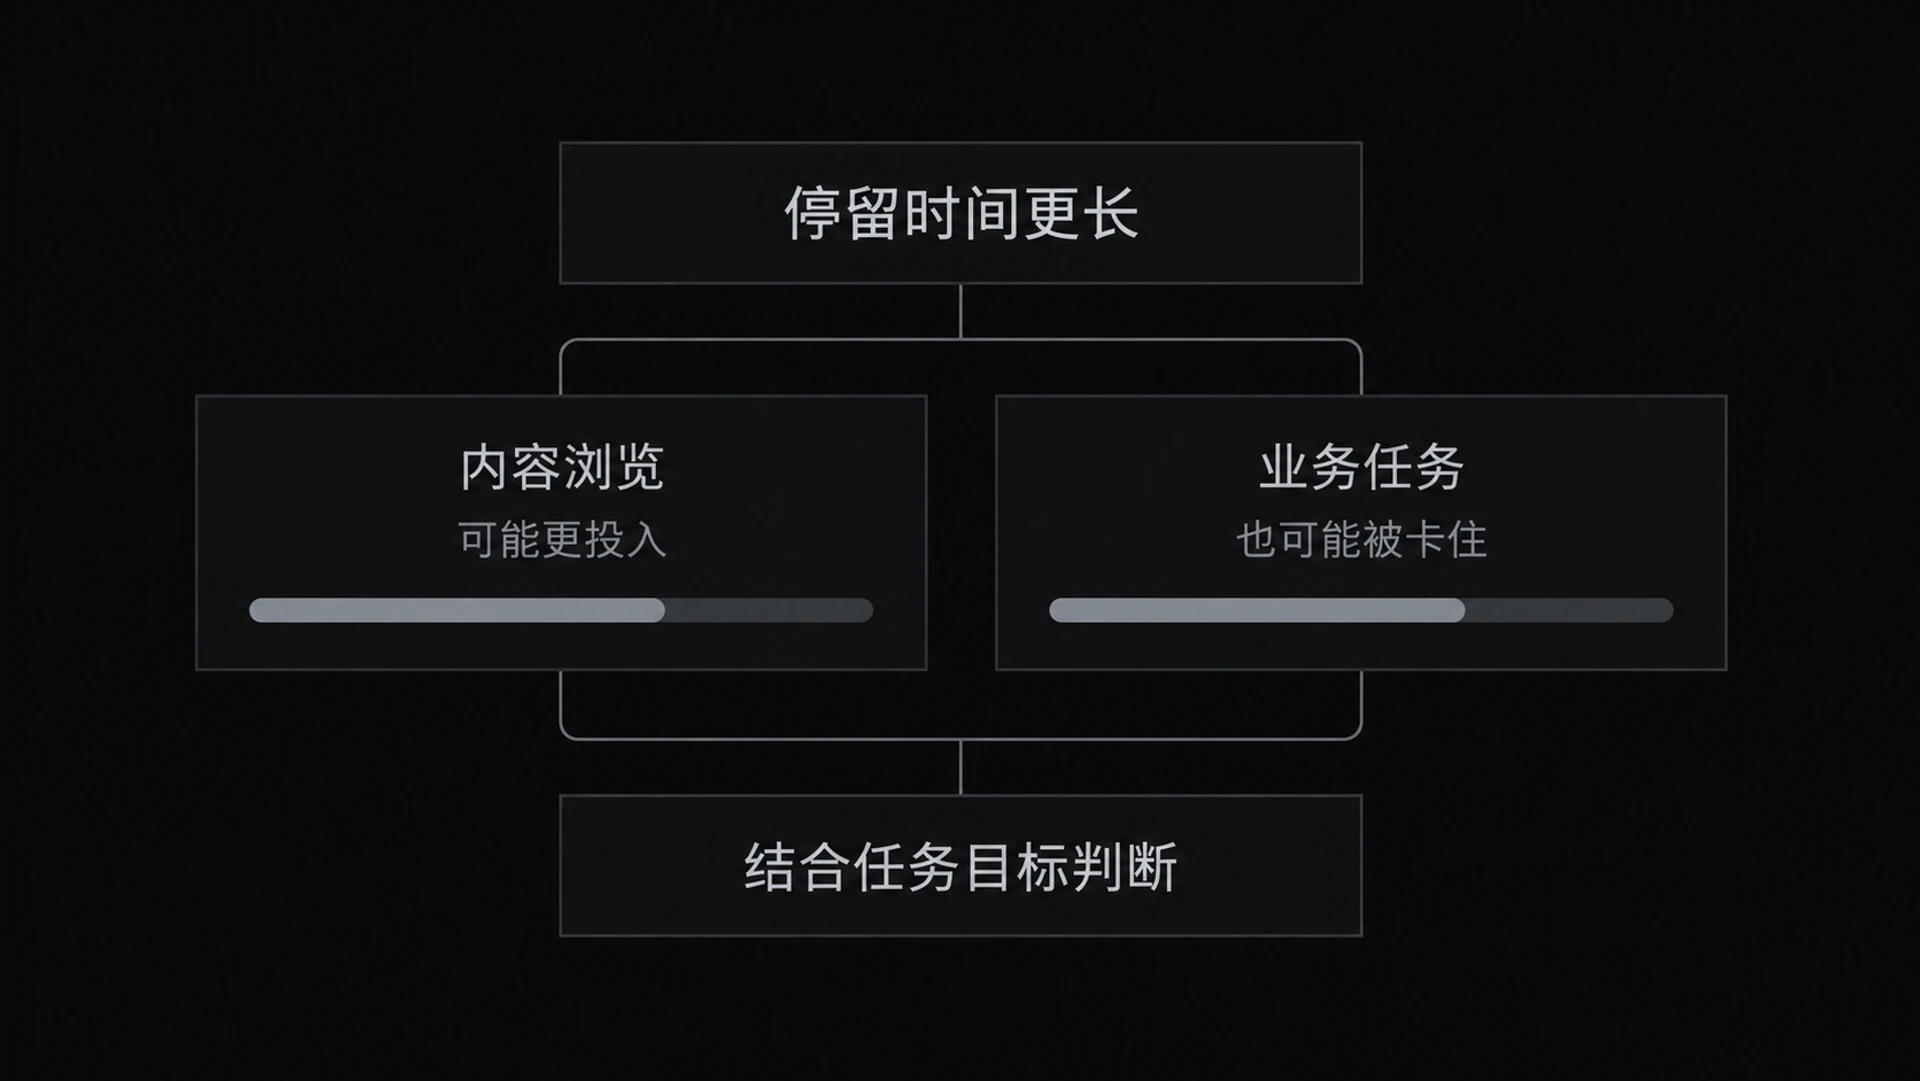
这里有一个最容易踩的、甚至会把方向带反的坑:如果你拿着 ToC 那套"停留时长越长越好"的指标来衡量 ToB,你会得出灾难性的错误结论。在 ToC,用户在一个页面停留久,可能说明内容吸引人;但在 ToB,用户在一个页面停留越久,很可能意味着他越困惑、越找不到、越卡住,这是个坏信号,而不是好信号。一个 ToB 设计师如果把"提升停留时长"当成目标,他会朝着"让用户更困惑"的方向去优化,南辕北辙。所以,选对指标,在 ToB 是头等大事。
这三条差异决定了:ToB 的数据驱动,不能是 ToC 的缩小版,而要有自己的一套打法。
二、建立 ToB 自己的指标体系
数据驱动的第一步,是想清楚"看什么数"。在 ToB,这意味着建立一套以效率和质量为核心的指标体系。我习惯把 ToB 的设计指标分成几层。
效率类指标,直接对应第一章的核心目标:完成一个任务要多长时间、多少步操作。任务完成时长、操作步数、到达目标的路径长度,这些直接反映了设计的效率,是 ToB 最该盯的一类。注意:这里"时长越短越好",和 ToC 恰恰相反。
质量类指标,反映用户用得对不对、顺不顺:操作错误率、表单校验失败率、撤销率、重试率、求助率(点帮助、找客服的频率)。这些指标里藏着大量的设计问题信号。我举一个用质量指标抓 bug 的例子:某表单某个字段的校验失败率高达 40%,也就是说,近一半的人在这个字段填错。这几乎一定不是用户的问题,而是设计的问题:要么这个字段的标签不清(用户不知道该填什么)、要么格式要求没说明(用户不知道要填成什么样)、要么这个要求本身就不合理。质量指标就像探针,哪个数字异常,哪里就藏着设计缺陷,顺着它去查,八九不离十。
采纳类指标,反映一个功能有没有被真正用起来:功能的使用率、渗透率、活跃度。ToB 里有大量"做了却没人用"的功能(投入了开发资源,却躺在那里吃灰)。采纳指标能帮你发现它们,然后反思:是需求不真(根本没人要),还是设计太难用(想用但用不明白),还是用户根本不知道有这个功能(可发现性差)?三种原因,对策完全不同。
满意类指标,反映用户的主观感受:满意度评分、NPS、特定任务的费力度(用户觉得完成这件事费不费劲)。这些主观指标,是对前面客观指标的补充,有时候客观数据还行,但用户主观上就是觉得难受,这种信号也要捕捉。
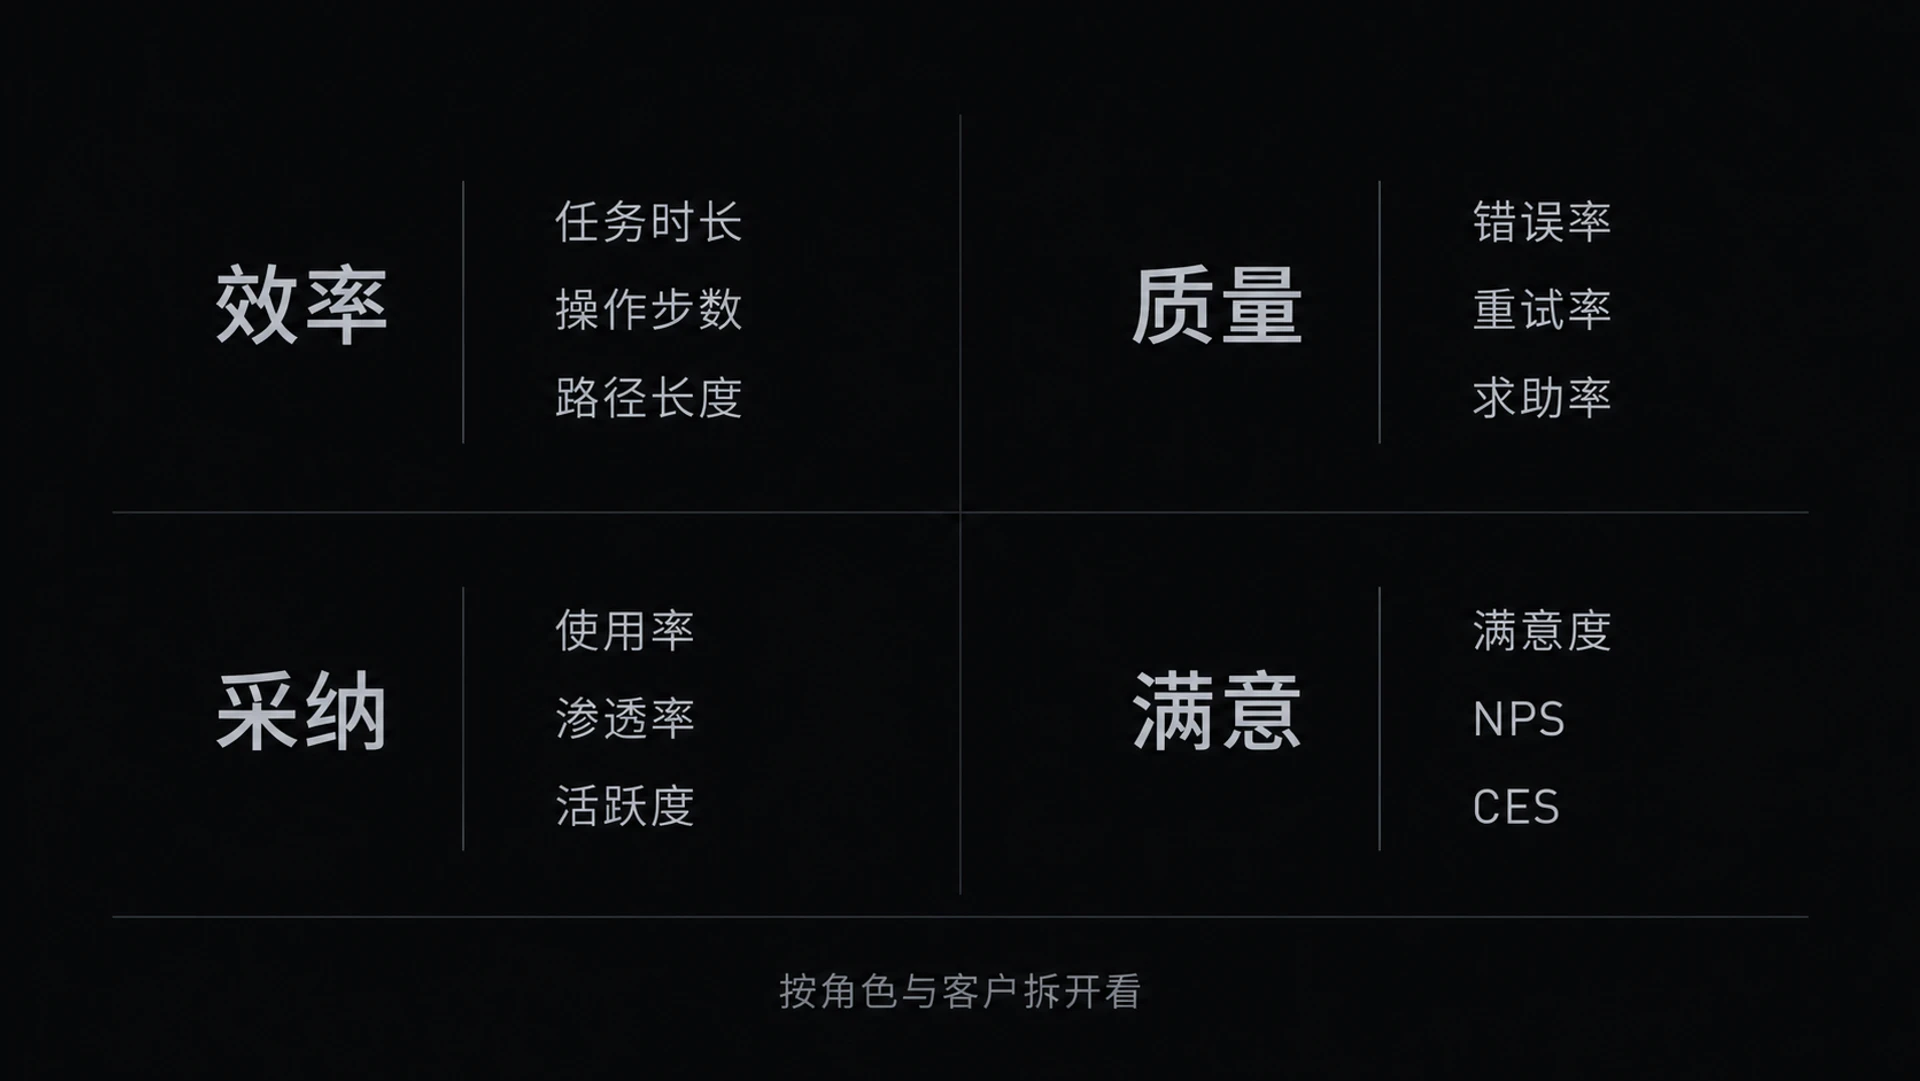
建立指标体系时,有一个 ToB 特别要注意的点:要能按角色、按客户类型拆开看,而不能只看大盘平均。
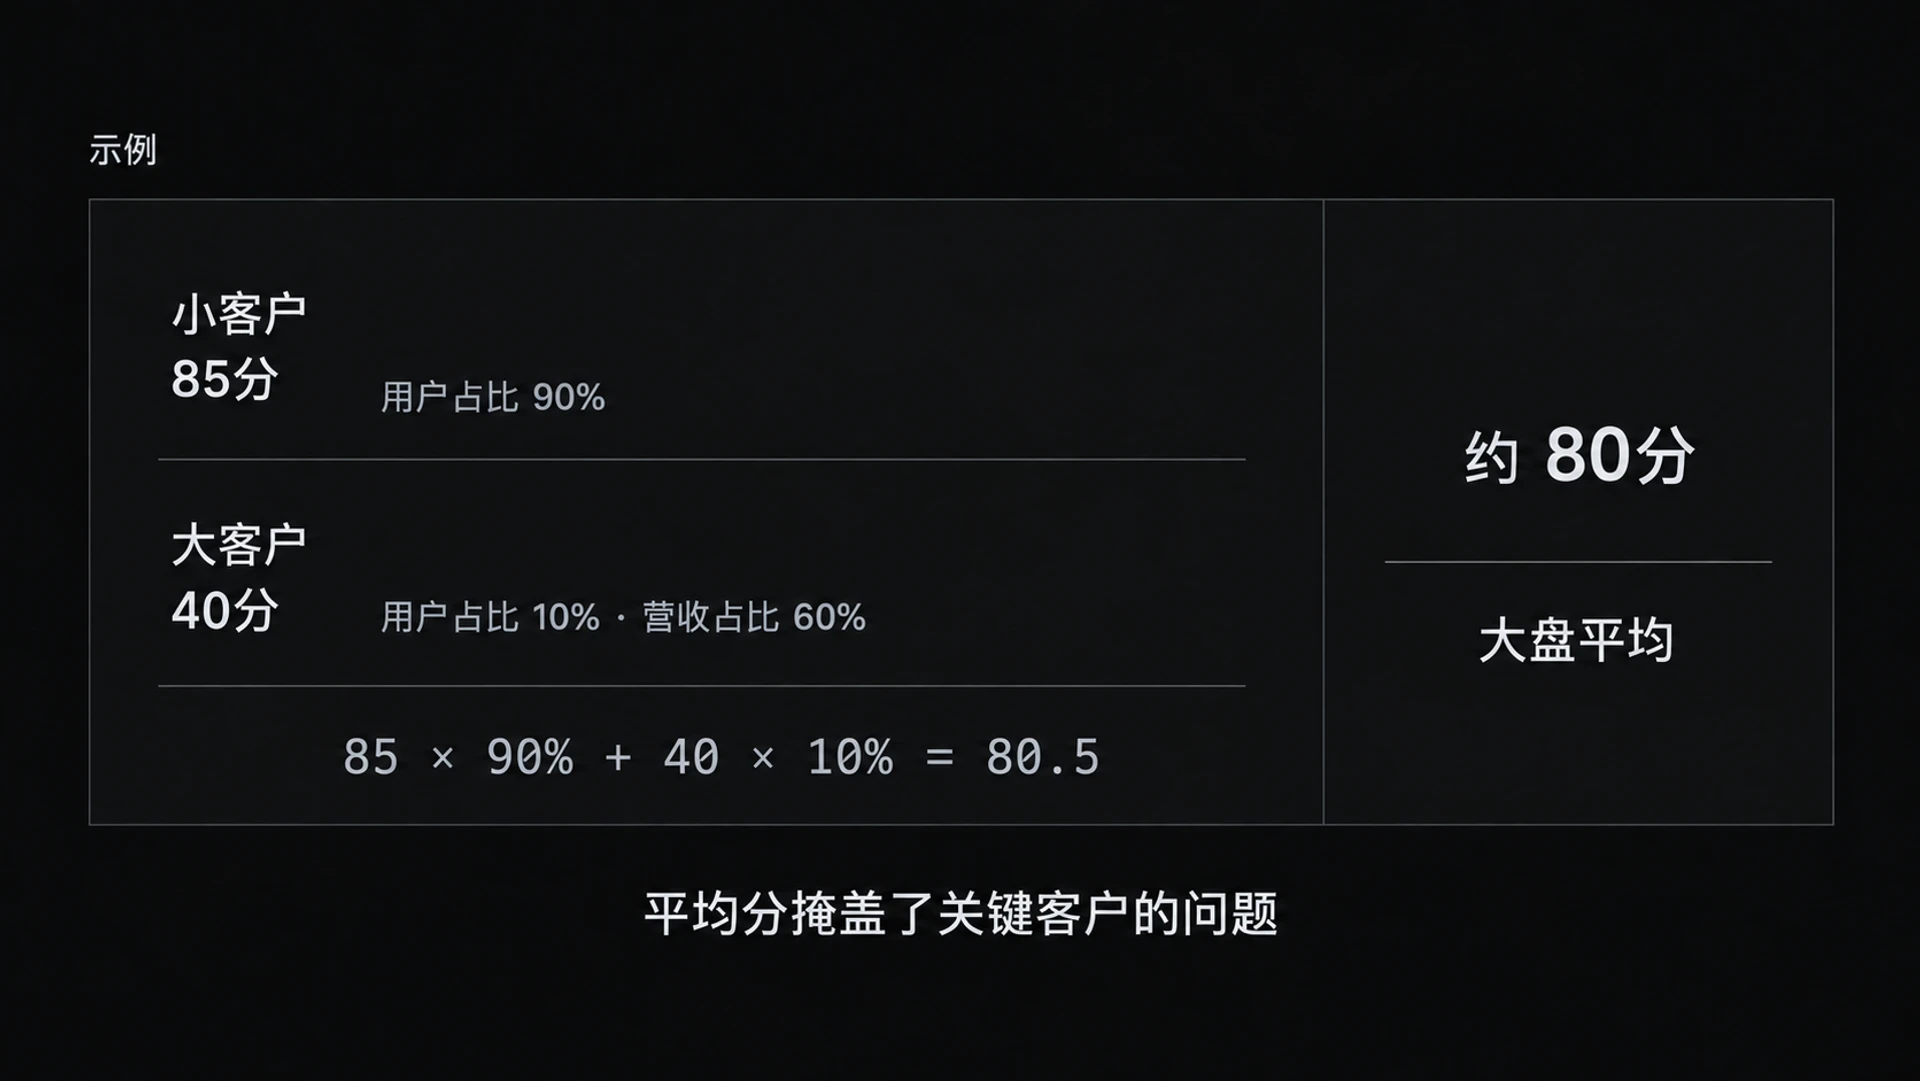
因为前面说的异质性,大盘平均在 ToB 经常是骗人的。我举一个例子:某功能整体满意度看着不错,80 分。但拆开一看,占用户数 90% 的小客户给了 85 分,而虽然只占 10% 用户数、却贡献了 60% 营收的大客户,只给了 40 分。大盘的 80 分,把大客户的强烈不满给"平均"掉了。如果你只看大盘,你会以为一切良好,继续这么走,直到某天大客户流失了才追悔莫及。把指标按关键维度(角色、客户规模、行业)拆开,你才能看到真实的、有差异的图景,也许整体没问题,但某个关键群体的体验很糟,只是被多数用户的数据淹没了。
三、A/B 测试:正视它在 ToB 的局限
说到数据驱动,绕不开 A/B 测试。它在 ToC 几乎是金标准:同时上线两个版本,看哪个数据好,简单直接、说服力强。但在 ToB,我必须坦率地泼一盆冷水:A/B 测试在 ToB 经常是不适用的,迷信它会害了你。
原因正是前面说的样本量。A/B 测试的有效性,建立在足够大的样本能跑出统计显著性的前提上。而 ToB 的小样本,常常根本达不到这个前提。
我举一个真实的尴尬:某 ToB 团队,机械地照搬 ToC 的流程,在一个日活几千的产品上做 A/B 测试。他们把用户分成两组,跑了整整一个月,最后的结果是"两组无显著差异"。团队对着这个结果一筹莫展,到底该不该上新设计?问题出在哪?其实问题不在设计,也不在他们不努力,而在方法用错了:几千的样本,跑不出统计显著性是必然的,这个"无显著差异"是个"假阴性",不是两个版本真的一样,而是样本太小、检测不出本来存在的差异。他们白白浪费了一个月,还可能因此放弃了一个本来更好的设计。A/B 测试这件"ToC 的趁手兵器",在 ToB 的小战场上常常是钝的。
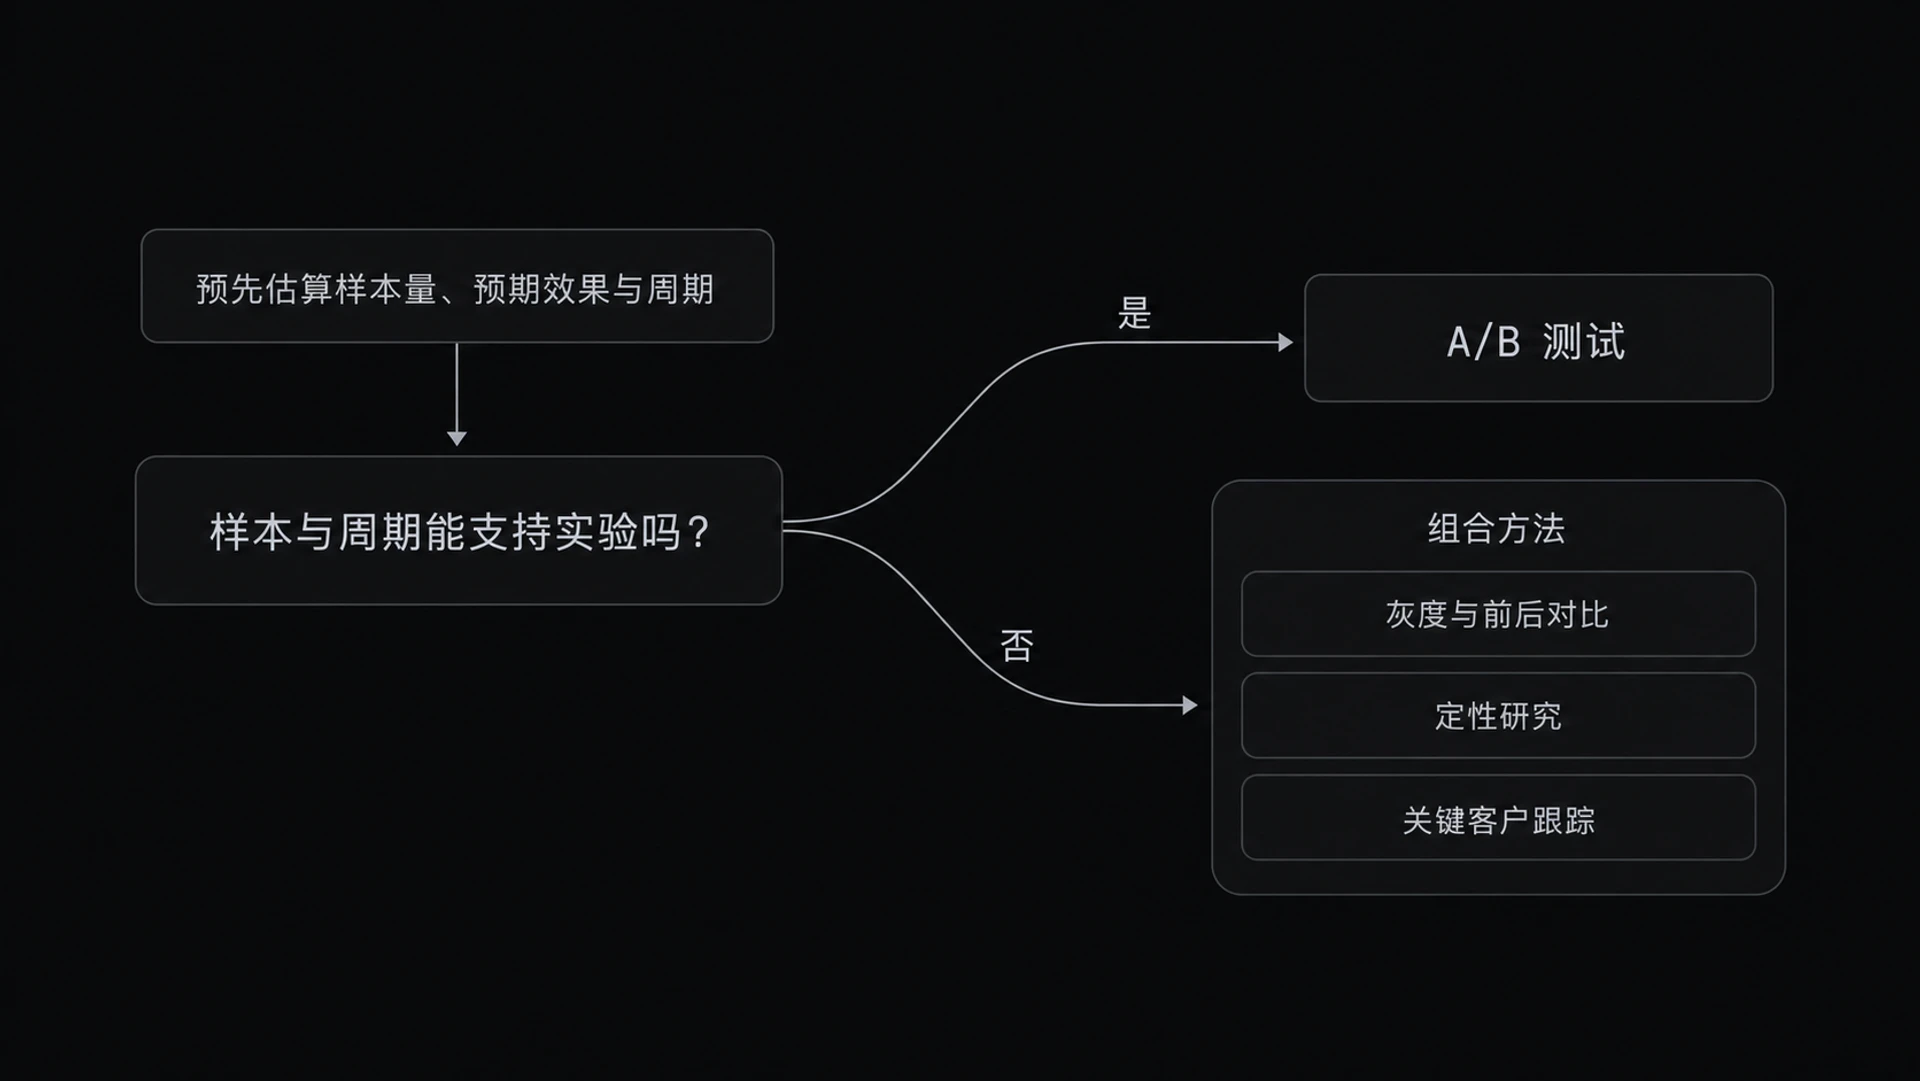
这不是说 A/B 在 ToB 完全没用。当你的产品用户基数确实够大(比如一些通用型的、用户量很大的 ToB 工具,像某些云服务的控制台),或者你要测的是一个高频的、所有用户都会遇到的小改动(改个按钮文案、调个默认值),A/B 依然有效。关键是要有判断力:先看样本量撑不撑得起,而不是不假思索地套流程。做 A/B 之前,先估算一下:以我的用户量和预期效果,多久才能跑出显著性?如果答案是"两年",那就别做 A/B,换别的方法。
四、ToB 的替代打法:组合拳
那么,当 A/B 测试不适用时,ToB 设计师靠什么来验证设计、驱动决策?答案是一套组合拳,扬长避短。
灰度发布与前后对比。不搞同时的 A/B,而是把新设计先在一小部分用户(比如某些客户、某个区域、某个团队)上线,观察一段时间,和上线前对比。这种"时间上的前后对比",虽然不如 A/B 严谨(混入了时间因素的干扰,比如这段时间正好赶上业务旺季),但在小样本下往往更实际可行,也能给出有价值的信号。配合灰度,你还能控制风险,出了问题,影响面小,好回退,这对低容错的 ToB 尤其重要。
定性研究的高权重。这是 ToB 相对 ToC 最大的不同,也是第三章就埋下的伏笔。当定量数据因为样本小而不可靠时,定性方法的价值就凸显了。与其纠结于跑不出显著性的数字,不如去做深度访谈、可用性测试、现场观察。在 ToB,"找五个关键用户,看着他们用新设计、听他们边用边说"得到的洞察,常常比"对着几千个模糊的、跑不出显著性的数字猜半天"要靠谱得多。ToB 设计师要敢于、也善于在数据不足时,用扎实的定性研究来支撑判断,而不是因为"没有数据"就不敢做决定。
关键客户的深度跟踪。ToB 常有一些举足轻重的关键客户(就像前面那个贡献 60% 营收的大客户)。与其在大盘上做粗放的统计,不如对这些关键客户做深度的、持续的跟踪:他们怎么用、卡在哪、提了什么、续约意愿如何、有没有流失的苗头。这种"窄而深"的跟踪,信息质量极高,对决策的价值往往超过"宽而浅"的大盘数据。
把这套组合拳用好,ToB 设计师就能在小样本的现实约束下,依然做到"有据可依"。数据驱动的精髓,从来不是"数据多",而是"判断准"。在 ToB,准确的判断,往往来自定量发现线索、定性理解原因、灰度小心验证的综合,而不是对某一种方法(尤其是 A/B)的机械迷信。
五、回到根本:数据指导判断,而非替代判断
这一章最后,回到开头的立场,把它讲透,因为它太重要了。
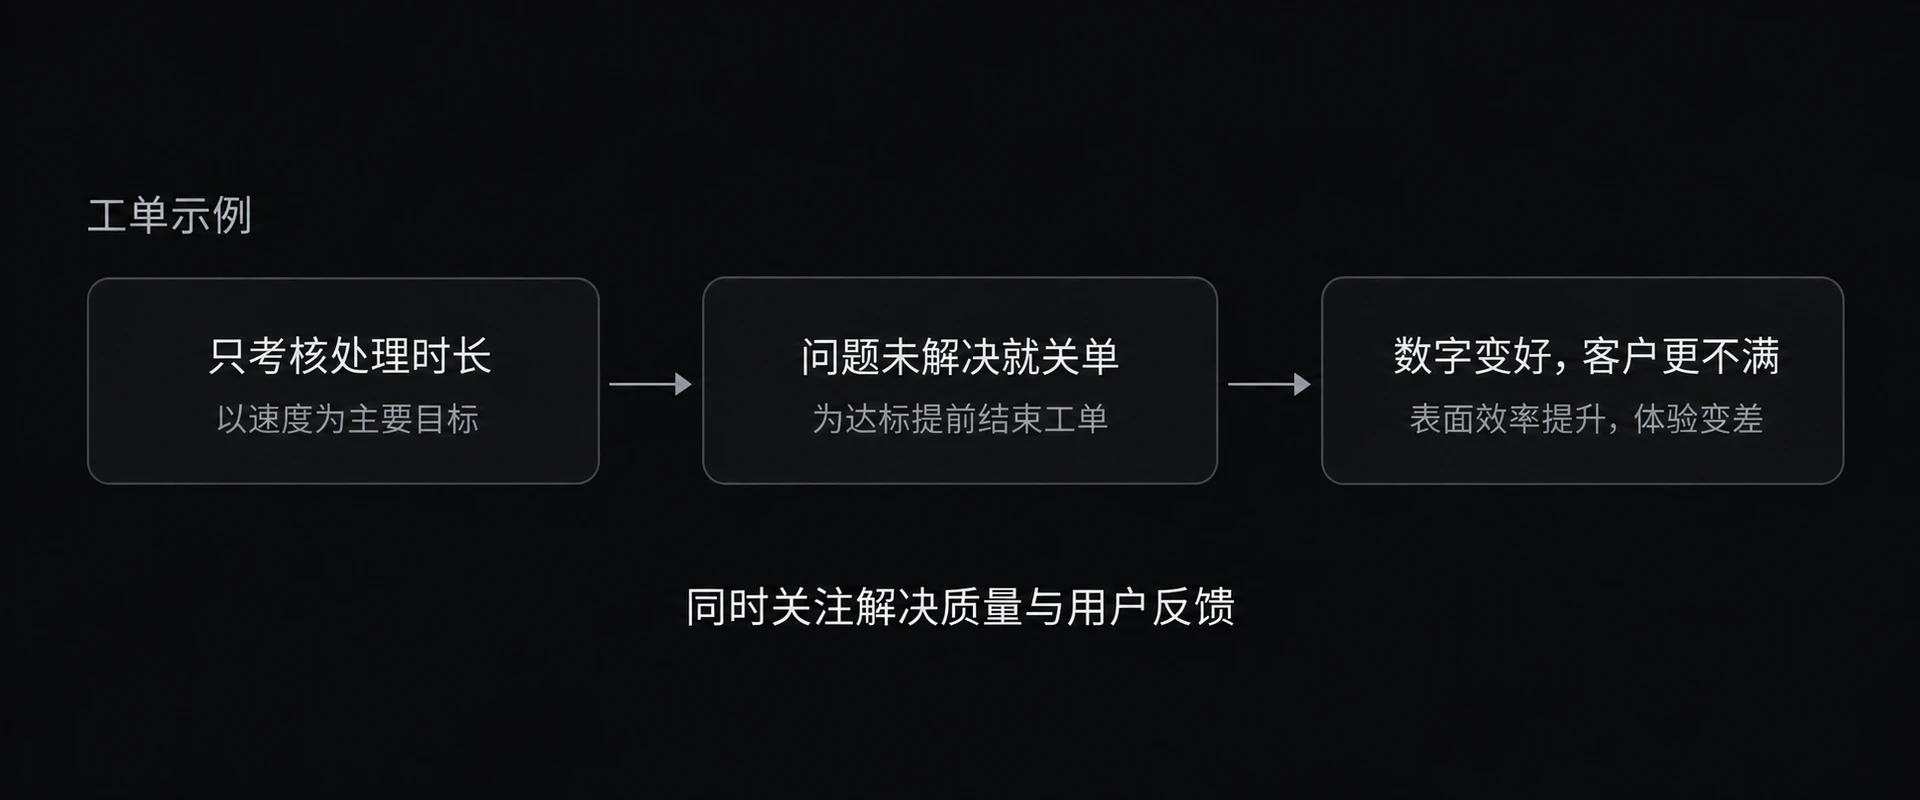
数据是个好东西,但它有它的盲区。数据能告诉你"发生了什么",但很难告诉你"为什么"和"该怎么办",这些依然需要人的判断和定性的理解。数据能反映已经发生的、可被度量的东西,但它照不到那些还没发生的、难以度量的价值,一个为长远体验打基础、短期数据却不好看的设计,数据可能会误判它,劝你别做。数据还容易被"优化指标"带偏。这里有一个著名的陷阱,叫古德哈特定律:当一个指标成为目标,它就不再是个好指标。当你只盯着一个指标猛冲,人(包括用户和团队自己)会想方设法去"优化那个数字",常常以牺牲那些没被纳入指标、却同样重要的东西为代价。比如你把"减少工单处理时长"定为唯一目标,客服可能会为了压低时长而草草关单、把没真正解决的问题硬关掉,数字漂亮了,客户更不满了。
所以,成熟的 ToB 设计师对数据的态度,是"重视但不迷信"。重视,是认真地用数据去发现问题、校准判断、验证方案,不凭空臆想、不靠拍脑袋,那是另一种不成熟。不迷信,是清醒地知道数据的局限,在数据照不到的地方,依然敢于、也善于运用自己作为设计师的专业判断和对用户的深刻理解。
让数据和判断彼此校准,这才是"数据驱动设计"在 ToB 应有的、成熟的样子。它既不是冷冰冰地被数字奴役,也不是任性地拒绝数据,而是理性与洞察的结合。又一次,这正是这本书反复想传递的那个内核:理性之美,不是用理性取消人的判断,而是用理性让判断更可靠、更经得起检验。
本章要点清单
- 核心立场:数据指导判断,不替代判断。被数据奴役和拒绝数据,都不成熟。
- ToB 与 ToC 三大不同:样本量小、用户异质、指标导向不同。
- 最大的坑:别用 ToC 指标(如停留时长越长越好)衡量 ToB——在 ToB 停留久往往是"困惑"的坏信号。
- ToB 指标体系:效率类(时长/步数,越短越好)、质量类(错误率/求助率,抓 bug 的探针)、采纳类(用没用起来)、满意类。
- 务必按角色/客户类型拆开看,别被大盘平均骗了(大客户的不满会被平均掉)。
- A/B 在 ToB 常因样本小而失效(假阴性);先估"多久能跑出显著性",再决定用不用。
- 替代组合拳:灰度 + 前后对比、高权重定性研究、关键客户深度跟踪。
- 警惕古德哈特定律:指标一旦成为唯一目标,就会被钻空子(压时长→草草关单)。
小结
这一章,我们厘清了 ToB 数据驱动的特殊性。它不能照搬 ToC,因为 ToB 样本量小、用户异质、目标不同(尤其别用停留时长这类指标)。我们建立了以效率和质量为核心的 ToB 指标体系,并强调要按角色、按客户拆开看;我们正视了 A/B 测试在 ToB 的局限,提出了灰度发布、高权重定性研究、关键客户深度跟踪的组合拳;最后我们回到根本:数据指导判断,而非替代判断,并警惕古德哈特定律。
数据的另一面,是如何把数据呈现给人,辅助决策。下一章,我们谈数据可视化与决策支持,让复杂的数据,变成能驱动行动的洞察。